让我睡觉,它替我开车:一夜 395 局的挂机脚本与一次内存惨案
先说边界
这不是”游戏外挂教程”,也不是”如何薅一款游戏的羊毛”。几点说明:
- 玩的是我自己手机上的单机游戏(Earn to Die 2,安卓),不联机、不涉及排行榜、不产生任何收益。跑它的动机很朴素:我想验证一套”无人值守自动化”的骨架能不能撑过一整夜。
- 文中所有性能数字都来自我自己机器上的实测日志(游戏每局自动写入的 CSV、守护进程的记录),没有估算冒充实测的地方;凡是我外推的,都会标出来。
- 全文用手机自己的
adb调试能力,不涉及破解、不修改游戏文件。 - 真正可复用的部分,和游戏一点关系都没有:长跑脚本的看门狗设计,以及内存泄漏在长时间无人值守下的表现。
一、它怎么”看见”和”下手”
《Earn to Die 2》是个很简单的横版游戏:从车库选车出发,在关卡里一路开,撞僵尸、飞坡、油用完或者速度掉到零就结束,结算拿现金,回车库升级,然后重复。
简单,但每一步都要”看屏幕”才知道自己在哪。所以脚本其实是三件事拼起来的:
| 环节 | 做法 | 为什么这么做 |
|---|---|---|
| 看 | adb exec-out screenrecord --output-format=h264 -,管道喂给 ffmpeg 解码成原始像素,转成 numpy 数组 |
手机是 2656×1220 的 2K 屏,我把它缩到 1280×588 再处理,够用且省 CPU |
| 读 | OCR(rapidocr-onnxruntime)读界面上的中文:按钮文字、”第 N 天”、结算金额 |
中文界面按钮位置会随进度变化,纯靠坐标会失手 |
| 动 | 常驻一个 adb shell 交互会话发点击/长按,而不是每次调 adb shell input tap |
每次起新进程约 300 ms,常驻会话只要 ~20 ms,一晚上省下来的是几百次卡顿 |
帧是这样拿到手的(e2d2_live.py,节选):
def read_exact(f, n):
    """管道 read(n) 会短读(实测只回 32KB) → 必须累积读满一帧"""
    buf = bytearray()
    while len(buf) < n:
        c = f.read(n - len(buf))
        if not c:
            break
        buf += c
    return bytes(buf)
然后是状态机:车库 → 点”出发” → 关卡里长按油门 → 结算 → 点”车库”,转圈。每个按钮的坐标不是猜的,是用圆检测先找出按钮轮廓,再用”点一下看哪几个像素变了”的帧差实验逐个确认的。
有一处特别有意思:游戏偶尔会插一段剧情对话,界面风格完全变了。OCR 出来的文本里会带一个 >> 符号——于是判据就是一句话:看见 >> 就当剧情屏处理,点掉它。比训练一个模型便宜多了。
二、一个人睡觉,五个闹钟
无人值守的难点从来不是”能不能自动玩”,而是出事之后它自己能不能爬起来。我这套脚本挂过几晚,翻过各种车:手机被碰掉线、screenrecord 卡死不出帧、光标卡在某个界面一辈子。
所以最终形态是五层守护,每层只干一件事,而且每层都跑两份(互为备份),一共十个进程:
| 层 | 职责 | 触发条件 | 处置动作 |
|---|---|---|---|
night_supervisor |
总调度 | 子进程退出 / 到点 | 重启子进程;到 deadline 后连带收工 |
night_reconnect |
抗掉线 | adb 设备消失 | 等设备回来,自动续挂,不打断进度 |
night_watchdog |
抗冻结 | 屏幕像素连续 30 s 无变化 | 判定卡死 → 杀掉重启 |
night_memguard |
抗内存 | 进程内存 ≥ 3400 MB | 杀进程树,交给 supervisor 拉起 |
e2d2_night |
本体 | — | 干活,每局往 CSV 记一行 |
这里有个设计上的取舍值得单说:守护进程不该”聪明”。它们只判断一个信号、只做一个动作,不做修复逻辑、不做重试策略。写复杂了,它们自己就是新的故障源。真正复杂的自愈逻辑全都写在下面那层(比如视频流自己的 _watch 线程:25 秒没有新帧就杀掉管道重连)。
还有一个我觉得很值的设计:到点自尽。我给这五个进程都塞了一个 deadline(这次是早上 7:00),到点各自退出,不需要我早上醒来去点什么东西:
if time.time() > deadline:
    log("=== 时长到, 收工 ===")
    break
实测效果:07:01 三个守护进程按 deadline 自行退出,07:03 本体跑完手头那一局、以返回码 0 退出,零残留进程。早上的我只需要看一眼日志。
三、凌晨 1:52:一晚上唯一一次真正的危机
现象:不是变慢,是”连锁失效”
半夜我盯着日志,看到的不是”程序变卡”,而是整个决策系统塌了:
- bot 内存一路涨到 4.8 GB,而我这台 16 GB 的机器上常驻着浏览器、微信、编辑器,可用内存只剩 1.1 GB;
- OCR 引擎(onnxruntime)开始报
bad allocation——它申请不到连续的几百 MB 内存; - OCR 一挂,脚本就读不出界面文字,状态机判定成”未知界面”;
- 于是视觉大模型兜底开始”自由发挥”,乱点;
- 点不对 → 崩 → 重启 → 内存又涨回来 → 再崩。
这是我这次最大的认知修正:内存不足的后果不是”慢”,而是”错”。 一个靠 OCR 感知世界的程序,内存耗尽等于失明,而失明之后它还在继续操作。
第一步:把范围缩小到一个变量
我先排除了几个嫌疑:OCR 引擎是懒加载的单例(只初始化一次)、日志是按行追加写文件、视频流是每帧新分配、每一局开头的运程记录列表都重置过。然后我把所有 append 都过了一遍,只剩一处可疑:
self.ring.append(f) # 🚩 全文件只有这一处 append 之后,再没有任何一处读取或清空它
ring 是开发阶段留下的调试缓冲,本意是”留最近几帧以备用”,但它被写成了普通列表,而且只写、不读、不清。每进一次循环就往后塞一帧画面。
第二步:一个把我自己骗过去的实验
第一版验证我写得很”合理”:分配 200 张同样尺寸的空白图,看看内存涨不涨。
结果:200 帧只涨了 0.8 MB,几乎等于没泄漏。
如果我就此收手,就会得出”不是这里的问题”的错误结论。真正的原因是:我用的是 np.zeros,而操作系统对全是 0 的干净页是懒惰的——先给你一个虚拟地址,等你真去写它才分配物理页,所以进程的驻留内存(RSS)根本不会上涨。
换成真的写了数据的帧再测一次:200 帧 → +435 MB,即 2226 KB/帧,和 1280×588×3 = 2,257,920 B 几乎完全吻合。真凶确认。
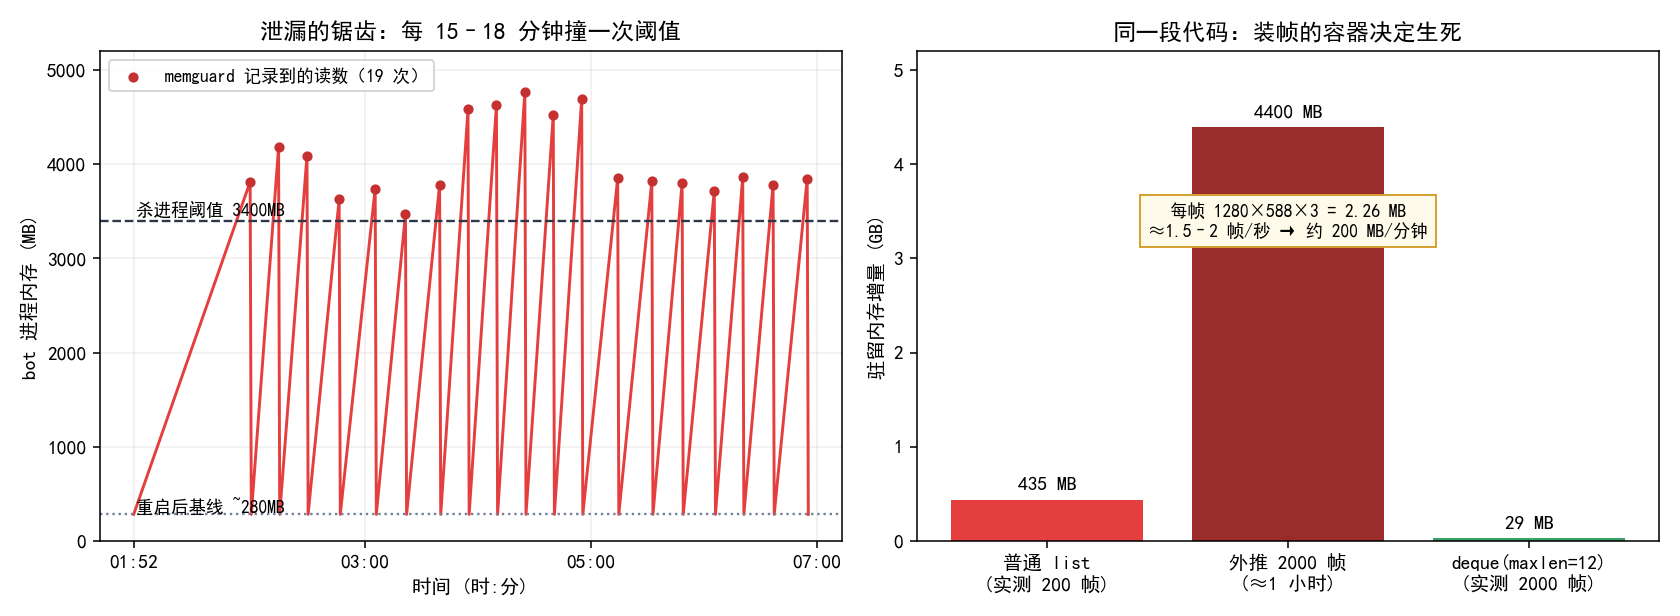
左图是 memguard.log 里的真实读数:每 15–18 分钟撞一次 3400 MB 阈值,一晚上撞了 19 次。右图是微实验——同一段循环,只把装帧的容器换掉,2000 帧的驻留内存从”外推 4.4 GB”变成”实测 29 MB”。
第三步:修复
- self.ring = []
+ self.ring = collections.deque(maxlen=12)   # 只留最近 12 帧,语义不变
一行改动:换成有界队列(deque)。按实际采样节奏(约 1.5–2 帧/秒)算,泄漏速率是 ~200 MB/分钟,而这一个改动把它归零。
顺带说一句:这个 bug 是我自己写的,而且是那种”看起来最无害”的代码——一个没人读的列表。它没让任何一次测试失败,只会在连续运行十几分钟后才现形。长时间无人值守,会把你所有的假设都真跑一遍。
四、这一夜的账
从 00:16 到 06:59,六个半小时:
| 指标 | 数值 |
|---|---|
| 局数 | 395 局(约 58.7 局/小时) |
| 游戏内天数 | 第 850 天 → 第 1247 天(+397 天) |
| 单局平均距离 | 1020 ft(约 311 m),最好一局 2972 ft |
| 平均速度 | 19.3 mph,最高 25.6 mph |
| 累计里程 | 399,680 ft ≈ 121.8 km |
| 结束原因 | “速度太慢” 327 局 / “燃料耗尽” 66 局 / 未识别 2 局 |
| 现金 | 38,185 M → 371,960 M |
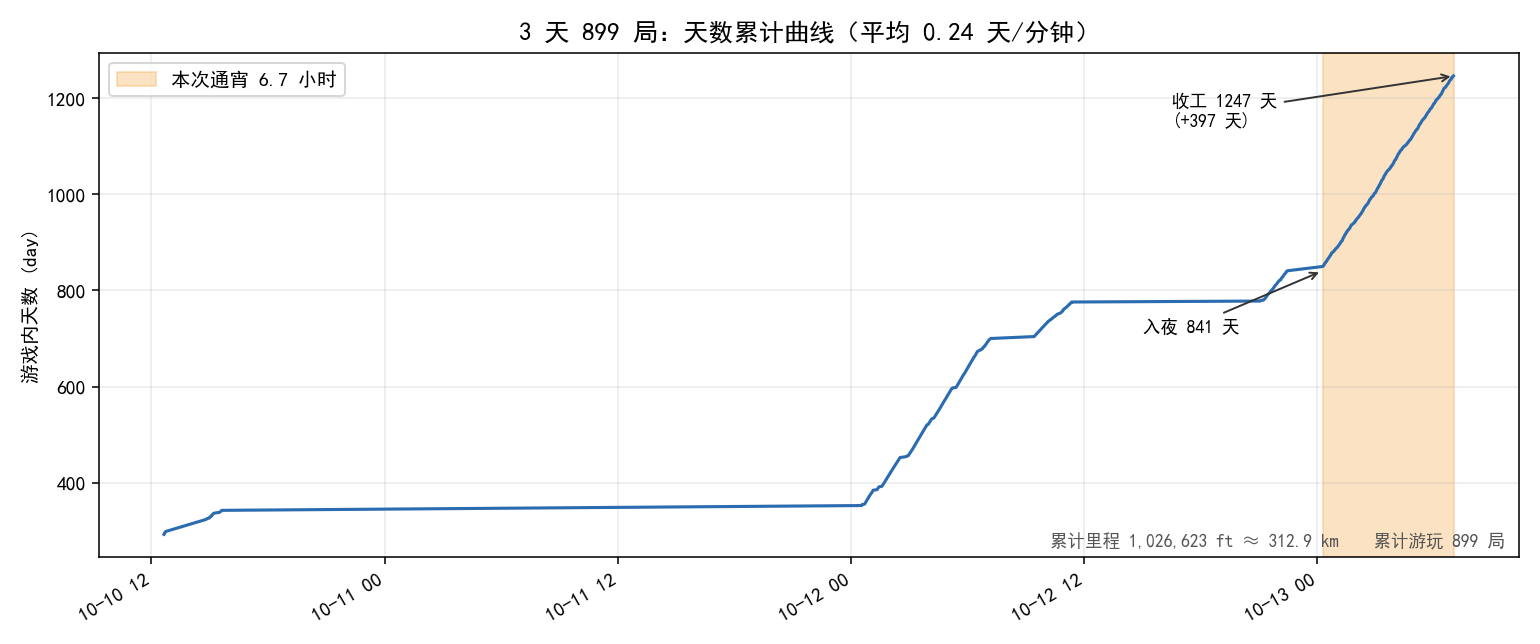
这张曲线回过头看更有意思:从 10 月 10 日中午(第 292 天)到 10 月 13 日早上(第 1247 天),899 局、312.9 公里的虚拟里程,平均推进速度 0.24 天/分钟。橙色那一段就是这次通宵——斜率明显变陡,是因为这一晚没有一局是因为”卡死”而浪费的。
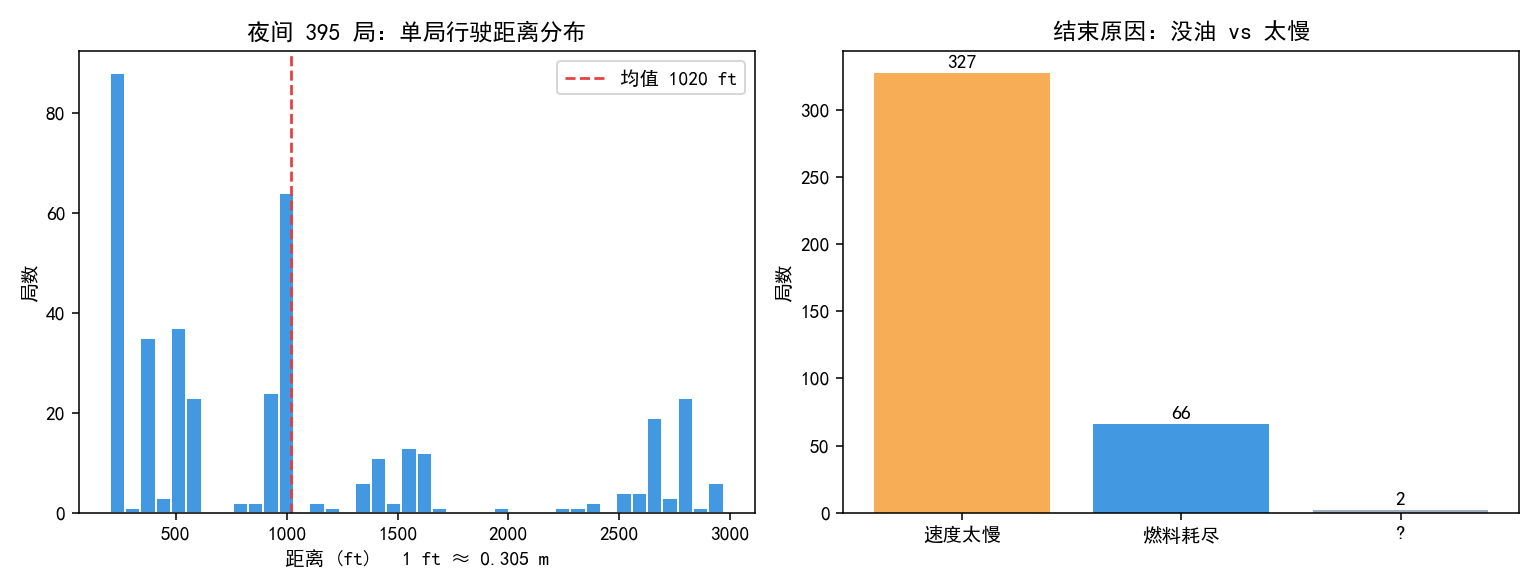
距离分布的形状也很诚实:单局距离在 900–1000 ft 附近堆成一座主峰,那是”燃料刚好烧完”的典型位置;右侧拖出一条长尾,是运气好撞上连续下坡的局。而结束原因里“速度太慢”占了 83%——说明这个游戏的瓶颈是”车跑不快”,不是”油不够”。
五、四条教训
- 只写不读的容器,是经典静默泄漏。 它没有测试能抓到,没有报错,没有日志,只在时间维度上现形。长跑程序里任何一个”先攒着以后再用”的结构,都应该天生带边界(
deque(maxlen=...))。 - 微实验要用”脏”数据。 操作系统对全零页是懒惰分配的,我差点用
np.zeros得出”没有泄漏”的假阴性。测量驻留内存时,必须让数据真的被写进去。 - 内存不足表现成”错误”,而不是”卡顿”。 对靠 OCR/模型感知世界的程序,内存耗尽的直接后果是感知失效,而它的动作还在继续——错误会被放大成连锁失效。所以监控内存本身,就是监控正确性。
- 守护要分层、要笨、要会自尽。 每层只认一个信号、只做一个动作,别在守护里写复杂的自愈逻辑;并且一定要有 deadline,让清晨的你不必做任何操作。
六、还能拿它干嘛
这套骨架(视频流 + OCR 读数 + 状态机 + 分层守护)其实和游戏无关。换成任何”有界面、有明确成功信号、又需要长时间重复做”的流程都能套:批量导出报表、反复重试某个不稳定流程、观察一个长期无人值守的任务是否还活着。
而内存那一课更通用:任何准备跑过夜的东西,先去量它的驻留内存曲线。一个 2 MB 的泄漏,在一分钟级的脚本里不存在,在一夜的脚本里就是一场事故。
附录:数据口径
- 数据源:游戏脚本每局自动追加的
days.csv(无表头,列序为 时间 / 天数 / 距离 ft / 结束原因 / 速度 mph / 现金 / 帧数 / 累计小时),以及memguard.log。 - “夜间”窗口:2026-10-13 00:16:06 – 06:59:46,共 395 行记录。
- “全程”窗口:2026-10-10 12:38:52 – 2026-10-13 06:59:46,共 899 行记录。
- 内存微实验:本机 CPython + numpy,样本尺寸
588×1280×3(uint8)。200 帧随机数据实测 +435 MB;2000 帧deque(maxlen=12)实测 +29 MB;”外推 4.4 GB”由 200 帧实测速率线性外推,已在图中标注为外推值。 - 修复后的一行改动的行为验证:语法检查通过 + 内存曲线对照实验通过;本轮通宵使用的是修复前的版本。