6 小时一道题:我做了一个「不许编」的 Agent
先说边界
- 这是 2026 秋招某高校实验室实习招募「智能体方向」的 take-home 试题(限时 6 小时)的做题记录。题目原文我不转录,只讲我自己怎么理解、怎么设计、跑出了什么数据。
- 文中所有数字都来自提交仓库里的真实产物(
trace.jsonl/evidence.json/run-summary.json/RUN_REPORT.md)和我本机刚才的实测;凡是外推或估算,我都会写出来。 - 代码是公开的、可以自己跑:https://cnb.cool/acidbunny/codewiki(CNB,可匿名克隆)。文中引用的实现片段都来自这个仓库的
main。 - 全程用的是 DeepSeek(OpenAI 兼容协议,thinking 模式),真模型跑一次真实仓库大约 19~68 轮。
一、题目到底在问什么
一句话概括我的理解:给你 6 小时,从零写一个小而完整的 Agent / Harness 原型,并且不许用现成的 Agent 框架。
这里的「Harness」不是玄学,它指的是模型外面那一圈干体力活、做规矩的程序:模型负责想和分析,程序负责调工具、管状态、守边界、在断掉之后还能接上。
题目给的要求不少,我把它压缩成五条,并顺手写下”它其实在防什么”:
| 题目要求(我的概括) | 它在防什么 | 我最后交了什么 |
|---|---|---|
| 自己实现 Agent 控制流 | 防「套壳」:把 SDK 的 run() 包一层就交 |
自研循环:组装上下文 → 调模型 → 校验输出 → 并发执行工具 → 状态判定 |
| 工具能描述、能选、能调,失败也要能看 | 防「PPT 工具」:写得漂亮但从没真跑过 | 7 个工具 + 参数白名单 + 重试 / 超时 / 同轮去重 |
体现真实异步,而不是把同步函数改成 async |
防「假异步」:await 满天飞但没有并发 |
asyncio.gather + Semaphore 限流 + 失败隔离,实测单轮并发峰值 3 |
| 支持 Human-in-the-loop,并处理好介入前后的状态 | 防「人只是观众」:所谓人工交互就是命令行按回车 | 两类打断点(决策门 / 审批门)全部落 SQLite,可以换个进程再续 |
| 可运行、可检查 | 防「只在我机器上能跑」 | 67 条离线单测 + 一次真实跑(11 篇 Wiki / 96 条行级证据) |
题面里还有一句很关键的话,大意是:不以功能数量作为主要评价依据,请优先保证核心控制流可运行、可验证。这句话直接决定了我的取舍——我砍掉了所有炫技的部分,把力气全花在「它说自己没编,我能不能证明它没编」上。
二、我把这道题翻译成了一句话
把要求摊开之后,我发现真正难的不是”会不会调 LLM API”,而是三个所有 Agent 都会碰到、又都不好演的问题:
- 模型会编。 让它总结代码,它会写出”这段实现了缓存与限流”——但源码里根本没有。人写文档会偷懒,模型写文档会编,而且编得很流畅。
- 长任务会断。 一次真跑几十轮、几分钟到十几分钟,中间撞上预算上限、上游报错、你按了 Ctrl-C,都是常态。
- 危险动作没人管。 「读文件」随便读,「写文件」可不行;模型一旦有写权限,它就会在下一次幻觉里把东西写到不该写的地方。
于是产品定义就一句话:不许编——每一条结论都必须带「文件 + 行区间 + 原文引文」,而且引用的文件必须是这次任务真的读过的,逐行对不上就直接拒绝入库。
三、它长什么样:一个循环、7 个工具、三本账
骨架非常朴素,就是一圈循环:
每一轮:
  组装上下文(build) → 调用模型 → 校验模型输出
    → 并发执行工具(dispatch_many:指纹去重 → 重试/超时 → 结果回灌)
    → 状态判定:继续 / 等待人工(WAITING_HUMAN) / 完成(COMPLETED) / 失败(FAILED)
每一轮收尾:
  原子写出 evidence.json / run-summary.json / trace.jsonl
跨进程:
  任务·步骤·检查点·人工决策·待恢复调用全部落 SQLite → status 查看、resume 续跑
模型能用的动作只有 7 个,全部登记在白名单里(未知参数直接拒绝,不让”幻觉出来的参数”被静默吞掉):
| 工具 | 作用 | 关键约束 |
|---|---|---|
inspect_repository |
仓库概览:文件清单、行数、顶层分组 | 只读,限定仓库根内 |
search_code |
关键词 / 正则检索 | 返回命中行号,控制输出体量 |
read_source_file |
按行区间读文件 | 行数上限;越界报 PATH_OUT_OF_SCOPE |
analyze_module |
确定性结构分析(文件、LOC、定义、导出) | 同轮可并发 |
ask_user |
请求人工决策 | 触发暂停 WAITING_HUMAN |
publish_wiki |
写出 Wiki 文档 | 副作用:需人工批准;证据逐行校验 |
finish |
结束任务 | 汇总产出单元与证据 |
外加”三本账”,都是纯文本、可以 diff、可以人工核对:
| 文件 | 记账内容 | 给谁看 |
|---|---|---|
evidence.json |
每条结论对应哪个文件哪几行、引文是什么、是否核验通过 | 想验证”它有没有编”的人 |
run-summary.json |
任务终态、轮数、人工门、续跑次数、产物清单 | 想快速看结果的人 |
trace.jsonl |
按 seq 排序的逐事件轨迹(模型请求、工具调用、状态迁移) |
想复盘过程的人 |
四、「不许编」是怎么变成代码的
最核心的就是一个函数。每次要写文档,它把每条证据拉回源码逐行核对,任何一条不过就直接抛错——宁可整篇不写,也不让一句编的话入库:
def _verify_evidence(entries: list[dict], ctx, doc_id: str = "") -> list[Evidence]:
    verified: list[Evidence] = []
    for entry in entries:
        relative = entry["file"]
        absolute = ctx.resolve(relative)          # 越界路径直接抛 PathOutOfScope
        if not os.path.isfile(absolute):
            raise EvidenceUnverified(f"证据引用了不存在的文件:{relative}")
        if not ctx.store.unit_done(ctx.task_id, f"read:{relative}"):
            raise EvidenceUnverified(
                f"未读过 {relative} 就引用其内容:请先 read_source_file 读取,再引用其中的行"
            )
        with open(absolute, encoding="utf-8", errors="ignore") as handle:
            lines = handle.read().splitlines()
        start, end = int(entry["line_start"]), int(entry["line_end"])
        if end < start:
            raise EvidenceUnverified(f"{relative} 的行号区间颠倒:{start}-{end}")
        if start < 1 or end > len(lines):
            raise EvidenceUnverified(f"{relative} 只有 {len(lines)} 行,证据区间 {start}-{end} 越界")
        window = "\n".join(lines[start - 1 : end])
        quote = entry["quote"].strip()
        if quote and quote not in window:
            raise EvidenceUnverified(
                f"{relative} 第 {start}-{end} 行找不到所引用的内容,疑似编造:{quote[:60]!r}"
            )
        verified.append(Evidence(file=relative, line_start=start, line_end=end,
                                 quote=quote, source_tool="publish_wiki",
                                 doc_id=doc_id, verified=True))
    return verified
四道关卡,每一道都在堵一种幻觉:文件不存在(瞎编路径)、没读过就引用(凭印象写)、行号越界或颠倒(大概记得在第 100 行)、引文对不上(内容记错了)。
效果就是,产物里的每一条证据都能被外人独立复核。下面是它读 Django 官方教程仓库(mdn/django-locallibrary-tutorial)时留下的真实证据条目之一:
{
  "doc_id": "module:catalog/tests/test_views.py",
  "file": "catalog/tests/test_views.py",
  "line_start": 304,
  "line_end": 305,
  "quote": "self.assertFormError(\n            response.context['form'], 'renewal_date', 'Invalid date - renewal in past')",
  "source_tool": "publish_wiki",
  "verified": true
}
拿这个路径和第 304~305 行去仓库里对,引文逐字一致——这就是它能被人当场拆穿、也不怕被拆穿的原因。
五、真跑:7 轮,把过程摊开给你看
写 Agent 最容易自欺欺人的地方,就是”我跑通了”。所以我给自己定了个规矩:每一轮真跑都留证据,失败的也要留。
前 6 轮跑本仓库自己(让它读它自己),第 7 轮换成远端真实仓库:
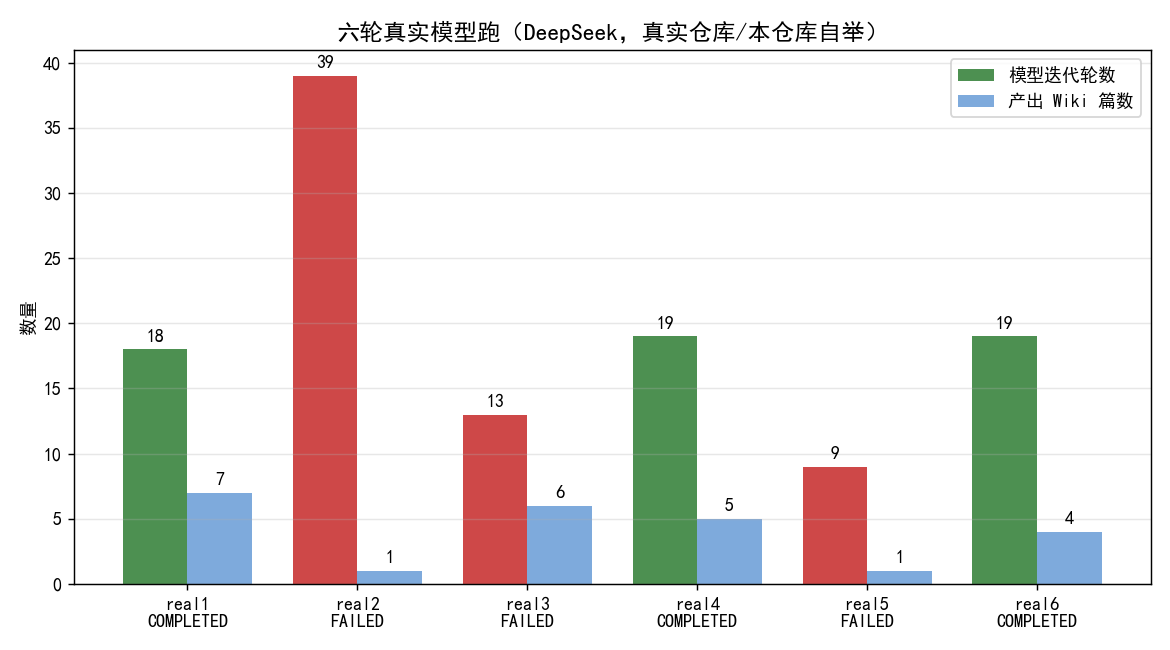
| 轮次 | 结果 | 模型迭代 | 产出文档 | 人工门 | 中断原因 |
|---|---|---|---|---|---|
| real1 | COMPLETED | 18 | 7 | 决策×2、审批×1 | — |
| real2 | FAILED | 39 | 1 | 决策×7、审批×1 | UPSTREAM_ERROR(reasoning 丢失,见下节) |
| real3 | FAILED | 13 | 6 | 决策×1、审批×1 | max_iterations(预算语义 bug) |
| real4 | COMPLETED | 19 | 5 | 决策×1、审批×1 | 中途熔断后跨进程续跑成功 |
| real5 | FAILED | 9 | 1 | 决策×1、审批×1 | UPSTREAM_ERROR(同一个 bug 复现) |
| real6 | COMPLETED | 19 | 4 | 决策×1、审批×1 | 中途熔断后跨进程续跑成功 |
这张表最值得看的不是”三次成功”,而是real2 跑了 39 轮却只产出 1 篇——那是我第一次撞上”上游 400”,也是我学得最多的一轮。
前 6 轮都在本仓库上跑,风险是”只对自家仓库有效”。所以第 7 轮换成了远端真实仓库:从一个 GitHub 仓库地址拉取 56 个文件,全流程跑完:
| 指标 | 值 |
|---|---|
| 目标仓 | mdn/django-locallibrary-tutorial @ main |
| 结果 | COMPLETED |
| 模型迭代 / 工具调用 | 56 / 153(其中工具级错误 13 次,全部被结构化回传后自愈) |
| 产出 | 11 篇 Wiki + 96 条行级证据,96/96 全部核验通过 |
| 过程 | 2 段进程(熔断 → 换个进程 resume)、1 次人工审批 |
再加上”让它读它自己”的自举跑(10 轮、15 条行级证据,COMPLETED),三种输入形态都有了真跑的底。
至于修 bug 有没有用,我用两次可比的成功跑做了对照——同一条任务、同一种模型,只差那几个修复:
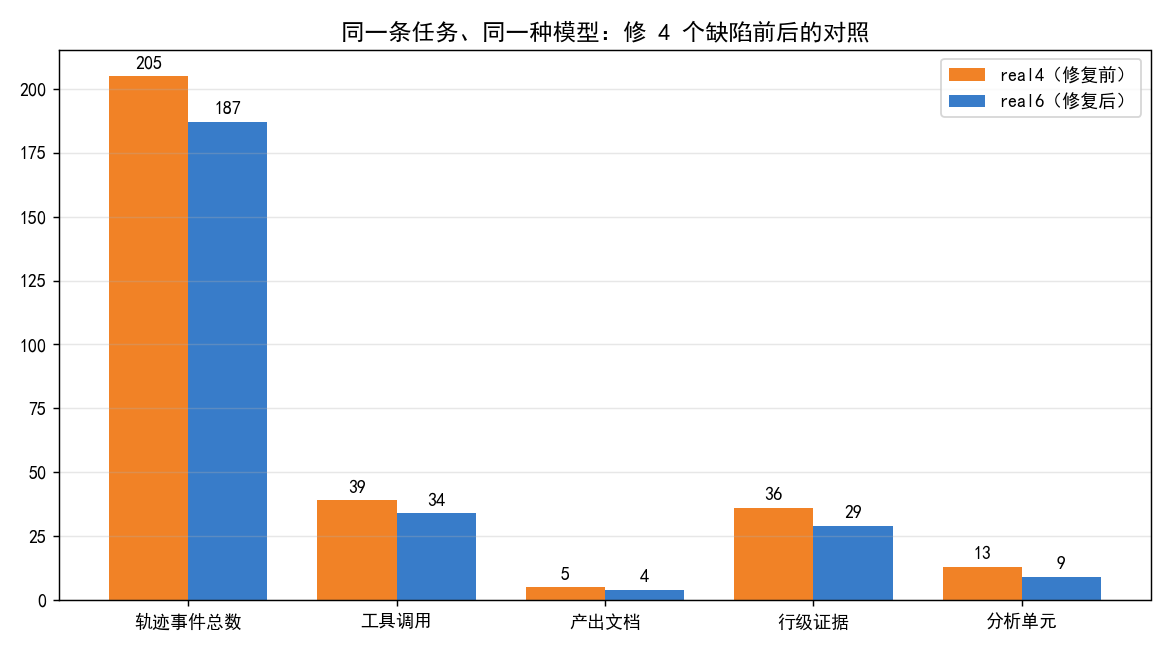
| 指标 | real4(修复前) | real6(修复后) |
|---|---|---|
| 轨迹事件总数 | 205 | 187 |
| 模型请求 / 工具调用 | 19 / 39 | 19 / 34 |
| 产出文档 | 5(含越界的 module-api-routes.md) |
4(全部落在已答决策范围内) |
| 行级证据 | 36 | 29 |
| 完成的分析单元 | 13 | 9 |
轮数一样、产出更少,恰恰是变好了:那篇越界的文档本来就不该被写出来。
最后是”别人能不能验证”这一条。离线单测全部不依赖网络与 API key,克隆下来一条命令就能跑:
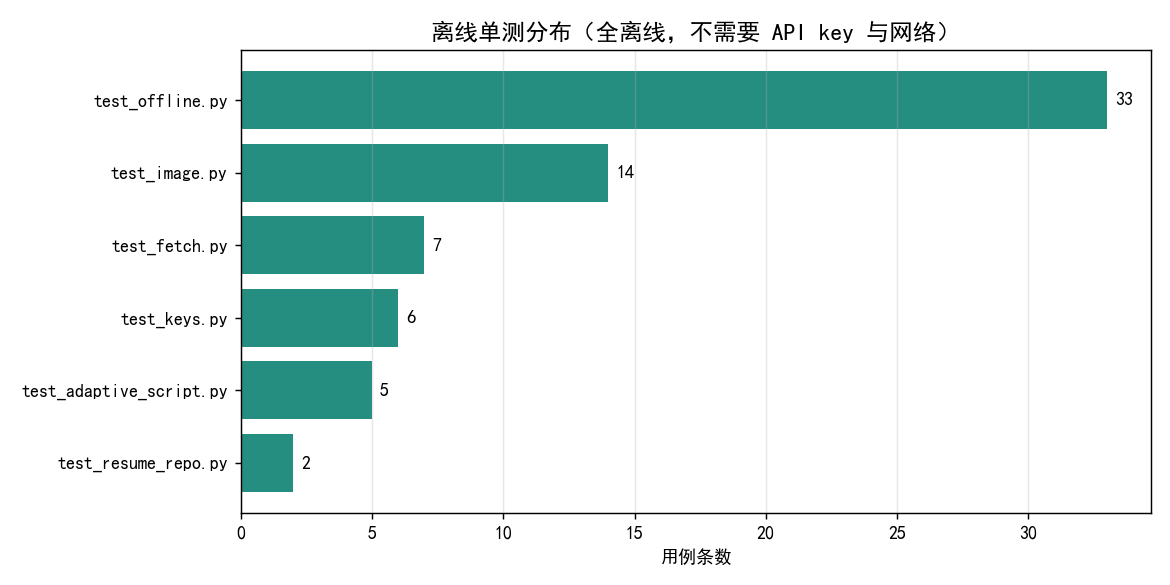
在仓库里刚跑的一次是 Ran 67 tests ... OK (skipped=7)。那 7 条都是镜像 entrypoint.sh 相关的用例——它们需要 POSIX shell,Windows 上跳过并原样打印理由,由 CNB 流水线在 Linux 容器里覆盖。跳过而不是假装通过,是我特意要的行为。
六、翻车清单(我觉得这部分比成功部分值钱)
真跑暴露出来的四个缺陷,每个都有原始事件为证:
| # | 缺陷 | 首现 | 修复 |
|---|---|---|---|
| 1 | thinking 模式下恢复执行时 reasoning_content 丢失 → 上游 400 |
real2 | 待恢复调用连同 reasoning 一起持久化;恢复时把同一回合的全部待批调用放进一条 assistant 消息 |
| 2 | 同一个人工决策被反复追问(real2 里问了 7 次) | real1 / real2 | 已答决策入库,ask_user 命中即复用,并记录 decision_reused |
| 3 | 人工已经限定了范围,模型仍然写出了范围外的文档 | real3 / real4 | 新增决策范围守卫,越界的文档单元直接拒(PATH_OUT_OF_SCOPE) |
| 4 | 迭代预算按”累计”计数,长任务被历史轮数提前熔断,且熔断后无法续跑 | real3 | 预算改为 per-run 语义;熔断状态允许 resume |
第 1 条最典型。原始报文长这样:
task_failed | UPSTREAM_ERROR
LLM 调用失败:BadRequestError: Error code: 400 - {'error': {'message':
'The `reasoning_content` in the thinking mode must be passed back to the API.'
翻译成人话:模型”想”的那段内容,也要原样还给它。 我在暂停-恢复的时候,只把 content 和 tool_calls 重新喂了回去,把思维链丢了,于是上游直接拒绝服务。而且 real2 和 real5 各出现一次、报文一致,说明这不是偶发。更细的一条:恢复时必须把同一回合的全部待批调用放进同一条消息,拆成多条一样会被判”不一致”。
工程上还有三个坑,属于”不写出来别人一定会再踩”的:
- 行尾符:往 CRLF 文件里插代码时,用
\n做替换会静默失败——补丁看着应用了,实际一行都没插进去。我后来改成显式写\r\n才修好。这类”不报错的失败”最难查。 - 解压包不等于仓库:本地全绿不代表 zip 解压后全绿。真实踩到两个——测试里硬调
git ls-files,没有.git的目录直接报错;镜像单测顶层import yaml,在零安装环境里整个模块挂掉。修复方式是”拿不到就回退文件系统扫描”和”缺依赖就跳过”。 - 文档里别写死数字:运行报告里那张单测表停在 52 条的快照(没算上后加的镜像用例),现在实际是 67 条。所以 README 里我只写”期望末尾 OK”,不写条数——数字会过期,行为不会。
七、交卷前的自检
提交包实测 125 个条目、约 0.48 MB,清单里没有 .git,也没有 key.py/.env/证书文件(只有 key.example.py 模板)。打包前逐条过了一遍交付清单:
- 可运行代码 + 依赖说明(核心链路纯标准库,第三方只有可选的
openai客户端); - README:安装 / 配置 / 运行方式 / 主要执行流程 / 7 个工具能力 / 已实现范围 / 关键限制,外加依赖是否参与核心执行链(题面明确要求,很容易漏);
- 一次实际运行结果(就是上面的第 7 轮产物);
- 能验证关键行为的测试与运行记录(
tests/+RUN_REPORT.md,报告里给的是原始事件而不是结论); - 配套文件与提交时间。
还有一条自检最有用:把 zip 解压到一个临时目录,在那里再跑一遍单测和离线 demo。前面那两个坑就是这么抓出来的。
密钥也是同样的思路:仓库里只有 key.example.py 模板,真实凭据文件在 .gitignore 里;打完包我会检查压缩包文件清单里不出现 key.py / .env / 任何证书文件。
八、复盘
如果只能留三条经验,我会留这三条:
- 先想清楚”我怎么证明它没编”,再动手写功能。 题面说”不以功能数量作为评价依据”,我一开始差点去堆工具,后来把力气全押在证据闭环上——它是这道题唯一能被外人当场验证的东西。
- 失败的那几轮才是资产。 real2 的 39 轮白跑换来一条”思维链必须回传”的硬结论,之后再没复发。只报成功的运行记录,本质上是把 bug 藏起来。
- 把”不确定”写在明面上。 我的运行报告里专门有一节叫”未覆盖与残余风险”:某个守卫只在单测里触发过、需要交互认证的私有仓库还没实测、同一状态库上并发
resume没有互斥……写出来不好看,但它是诚实的。
另外一个必须交代的前提:这道题允许使用 AI Coding 工具,我也确实用了——构思、写代码、写测试、跑回归,AI 都深度参与。但题目同时写明”最终提交内容视为候选人本人认可的工程产出”,所以我的做法是:凡是写进交付物的数字,我都自己看过原始产物(哪条证据、哪一行、哪个报错报文),AI 说”通过了”不算通过,trace.jsonl 里没有那条事件就不算发生。
延伸阅读
- 仓库(含
docs/与运行报告):https://cnb.cool/acidbunny/codewiki - 想亲手验证”它真的不编”:仓库里的
docs/EAT_DOGFOOD.md,三步走,约 1 分钟,不需要任何模型凭据——克隆、跑单测、然后用它读它自己,再打开evidence.json逐条对着源码核。 - 想看重跑数据:
RUN_REPORT.md(7 轮真跑的原始事件引文、缺陷与修复对照)。
如果你也在做类似的东西,最想听的一句反馈是:你的 Agent 说”我读过了”,你怎么知道它是真读过,还是在忽悠你?